エージェント健全性を監視する
学習の目的
この単元を完了すると、次のことができるようになります。
- AI エージェントに対するプロアクティブな自動健全性監視の価値を説明する。
- 標準メトリクスとカスタムスコアの実用的なしきい値を設定したアラートを作成する。
- 関連するセッションや会話をドリルダウンして、アラート通知を調査する。
- アラートの調査結果に基づいて、エージェントの改善策に優先順位を付け、重点的な改善策を実施する。
Alex Wu はすでにエージェント分析や [Sessions & Intents (セッションとインテント)] を活用して、Coral Cloud Resorts の Excursion Booking (オプショナルツアーの予約) エージェントを改善してきました。デフレクション率が上昇し、エスカレーション数は減少しています。利用状況が好転する中で、Alex は特定の時点のスポット分析だけでは不十分と考えています。
これからは、ゲストが気づく前にパフォーマンスの問題を検知し、フラグを設定できる早期警告システムが必要です。つまり、問題が起きてから対処するリアクティブなトラブルシューティングから、プロアクティブな健全性監視に移行するということです。
エージェントの健全性を積極的に監視する理由
AI エージェントが処理する実際の顧客トラフィックが増えるにつれ、障害が急速に拡大する可能性があります。予約が集中する時間帯に遅延が急増すれば、数分のうちに放棄率が高まるおそれがあります。エラーが突発的に増えた場合、誰かがダッシュボードを開いて気づく前に、複数のサブエージェントに影響が及んでしまう可能性があります。
エージェント健全性監視があれば、チームがこうした人目につかない障害をほぼリアルタイムで検知して、迅速に対応できるようになります。
健全性監視を導入すると、Alex とそのチームは次のことが可能になります。
- 新たな問題が出現したときに、ゲストが直面するインシデントになる前に察知する。
- 自動通知を活用して、平均検出時間を短縮する。
- 懸念の原因となった特定のセッションに絞って調査を実施する。
- 推測ではなく、測定可能なシグナルに基づいて修正の優先順位を決める。
- エージェントが長期にわたって許容可能なサービスレベルを維持しているという確信を得る。
このワークフローは、エージェント開発ライフサイクル (ADLC) の監視フェーズ (観察、調査、改善、再び監視) に対応します。
エージェント健全性のアラート機能を設定する
Alex は Agentforce スタジオを開き、[Observe & Optimize (観察および最適化)] に移動して、Excursion Booking (オプショナルツアーの予約) エージェントにアラートを設定します。
ここから、次の両方を監視できます。
-
標準メトリクス: エラー率、インタラクション時間 (遅延) など
-
カスタムメトリクス: 独自のユーザーセンチメントスコアに基づくリゾートゲストのユーザー満足度など
アラートの設定内容
各アラートは次の要素に関連付けられます。
- 選択した標準またはカスタムメトリクス
- 特定の AI エージェント
- しきい値条件 (例: 以上、以下)
- 許容可能なパフォーマンスの境界を示すしきい値
監視対象のデータがしきい値を超えると、システムから通知が送信されるため、Alex がすぐに調査に着手できます。
まずベースラインを確立して、しきい値を設定する
Alex はしきい値を適当に決めるのではなく、 再現可能なプロセスに従います。
- 選択したメトリクスの過去 30 日分以上のデータを確認する。
- 正常な変動範囲を特定する。
- ビジネス関係者と相談して、ゲストエクスペリエンスの許容範囲を定義する。
- 正常な変動を外れ、措置が必要となるしきい値を設定する。
- エージェントの動作が変化したら、しきい値を見直して調整する。
たとえば、Excursion Booking (オプショナルツアーの予約) エージェントのインタラクション時間は通常 1.8 ~ 4.6 秒の範囲で、遅延が 5 秒を超えるとゲストが違和感を覚えるという報告がカスタマーサービス部門から寄せられたとします。この場合、オレンジ色の水平線で示されているように、Alex はアラートのしきい値を 5 秒 (以上) に設定できます。
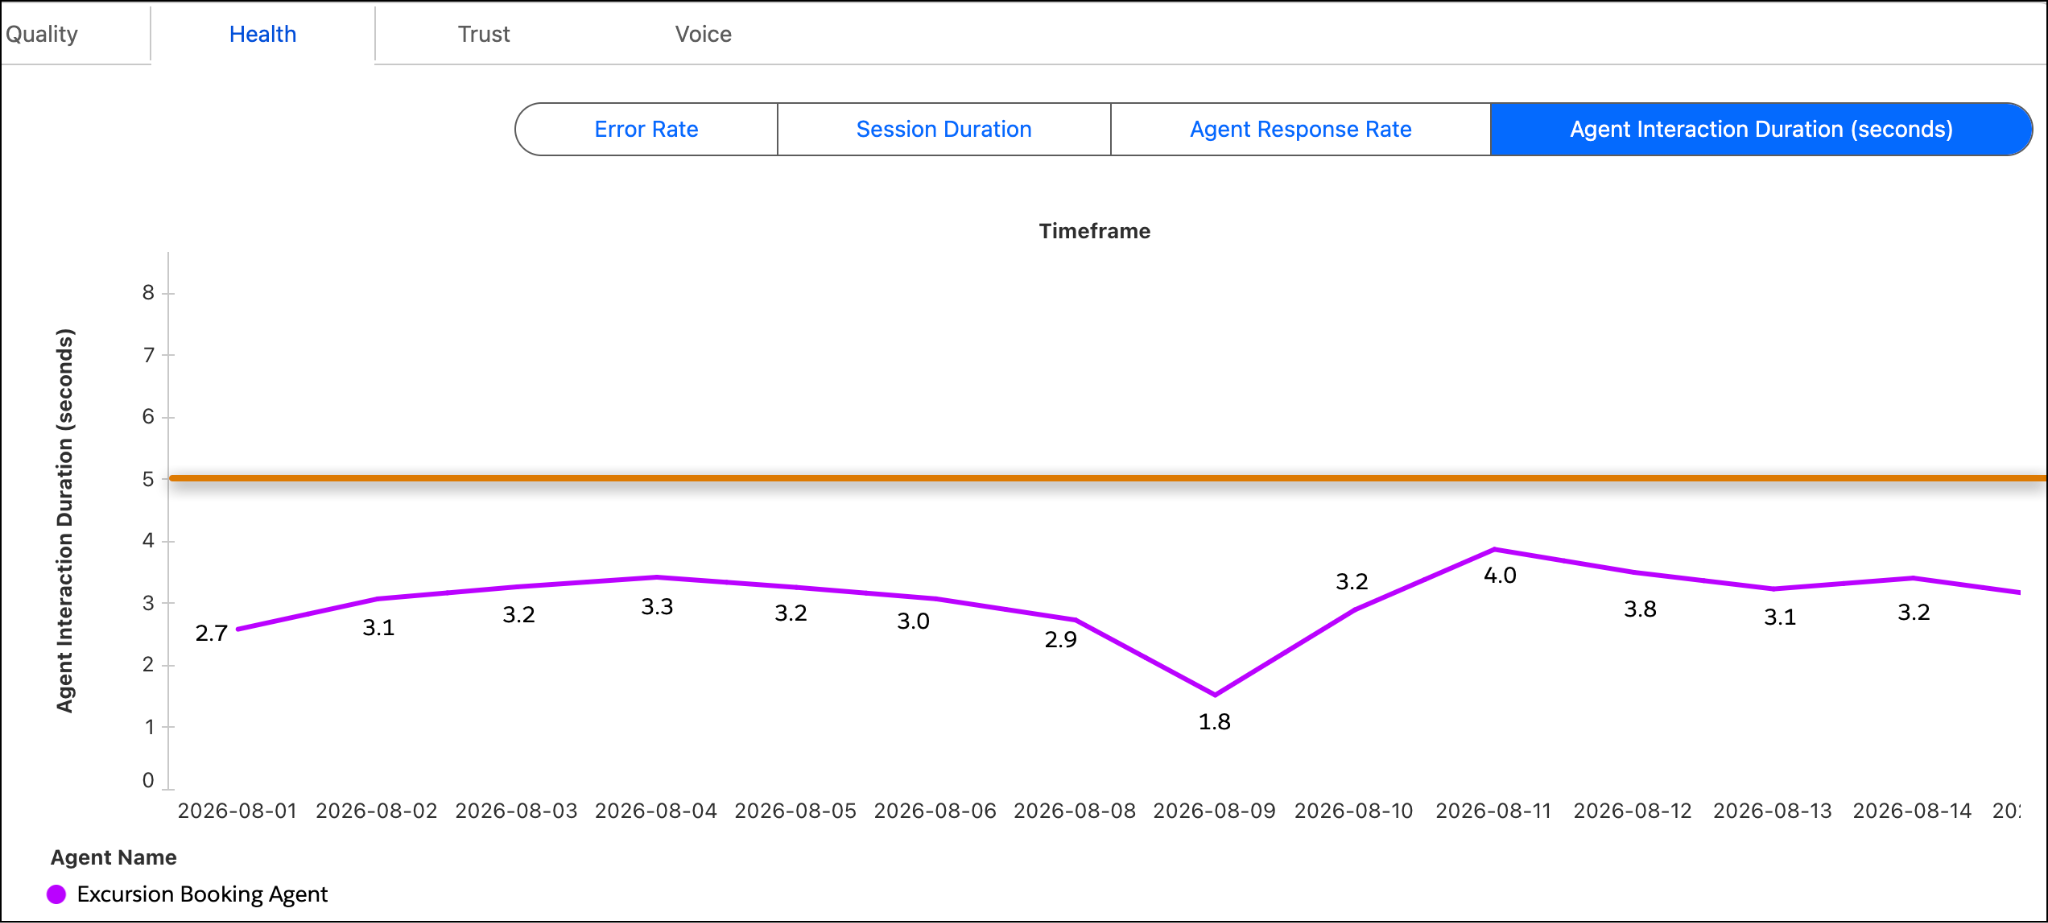
さらに、健全性に影響するほかのメトリクスにも同じロジックを適用します。これで、ノイズを抑えつつ、重要なリスクを把握できる実用的なアラートが設定されます。
Alex のアラート計画の例
Alex はまず 2 つのアラートを作成します。
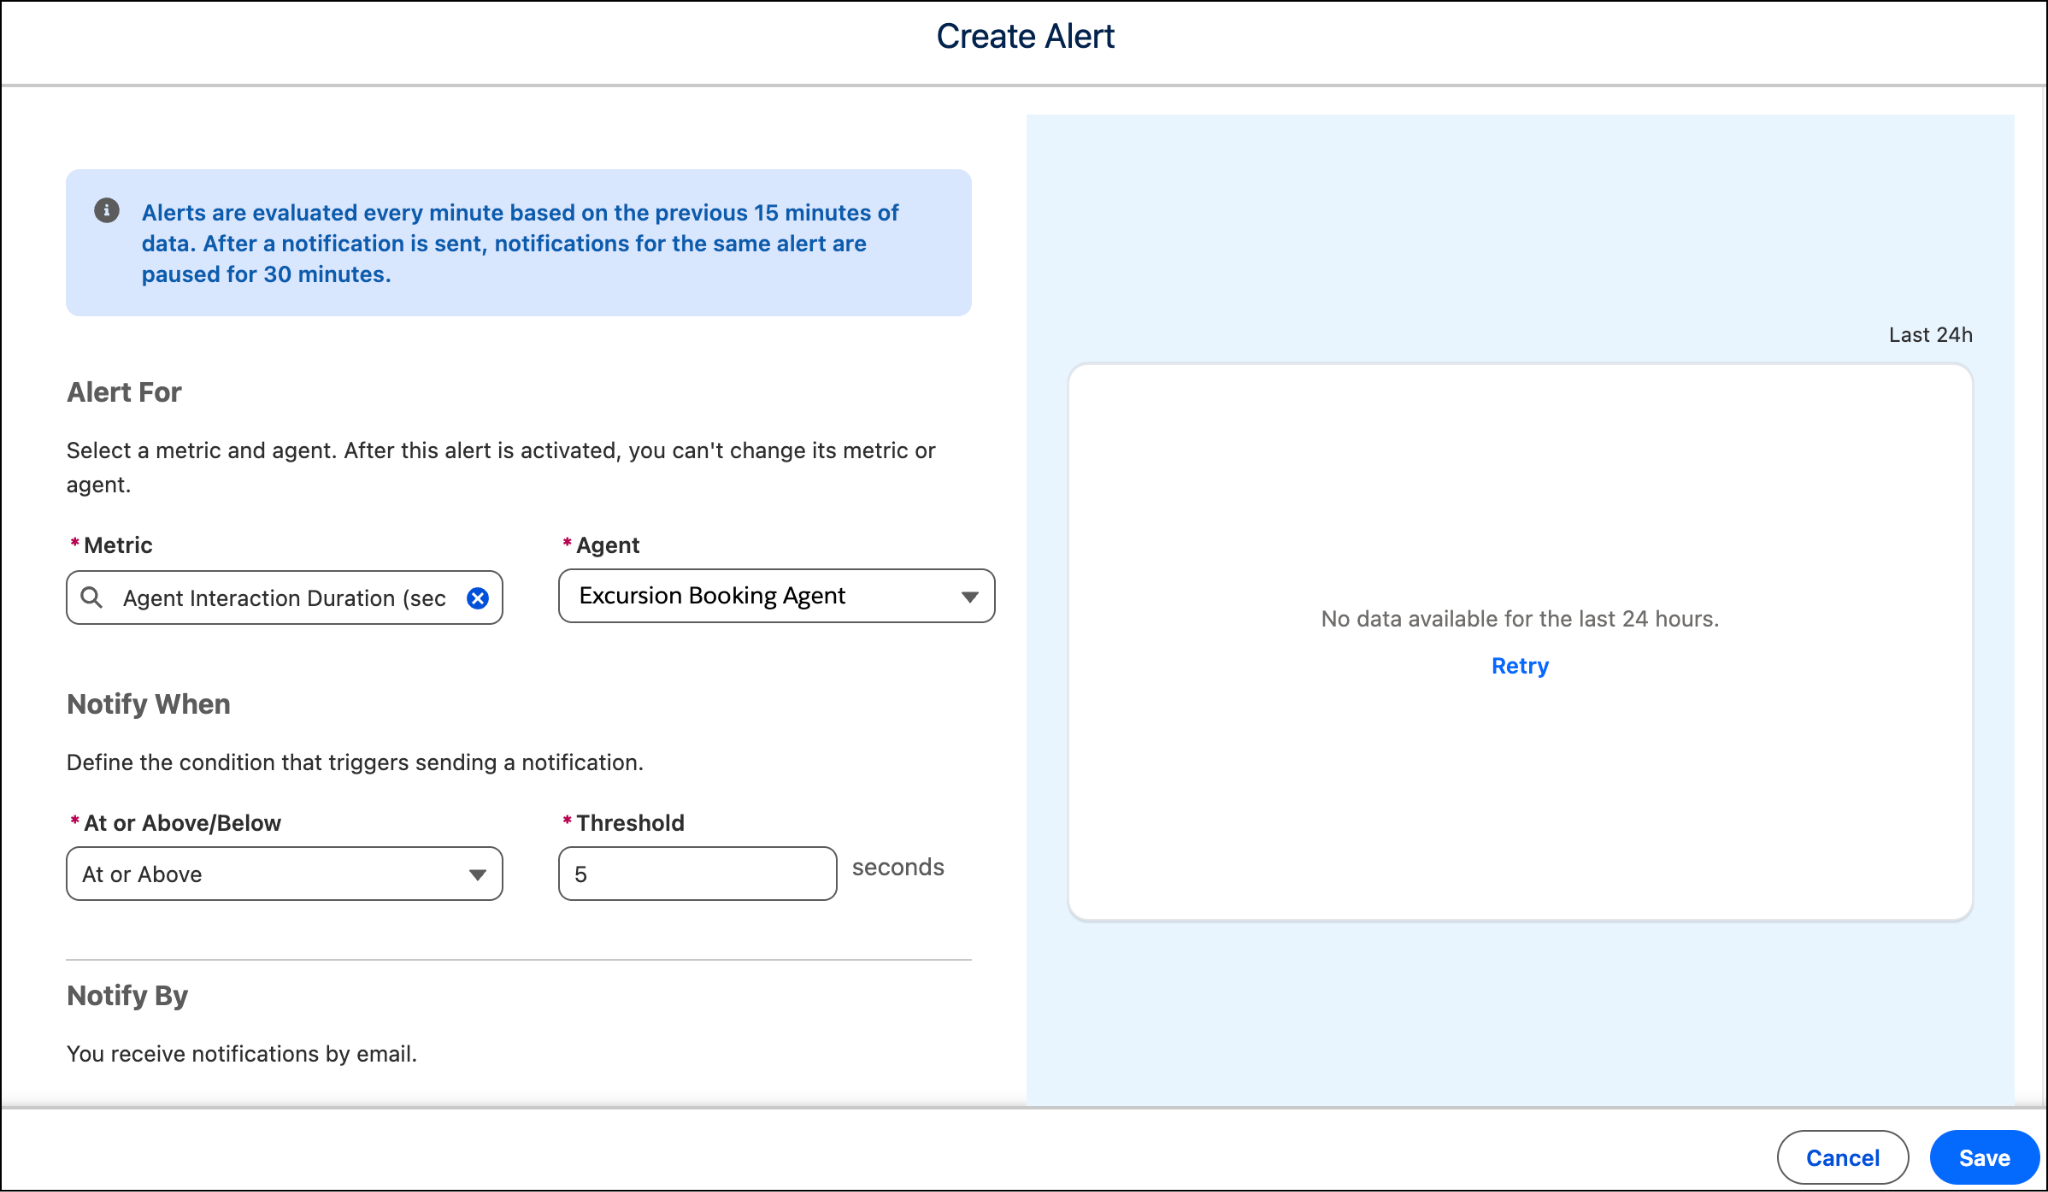
-
Agent Interaction Duration (エージェントのインタラクション時間): インタラクションの平均時間がサービス目標を超えた場合にトリガーされます。
-
Elevated Error Rate (エラー率の上昇): 応答処理エラーが正常な範囲を超えた場合にトリガーされます。
この 2 つのアラートを組み合わせれば、速度と信頼性の両方に対処できます。
通知を調査して根本原因をすばやく特定する
2 週間後、Alex が「Excursion Booking (オプショナルツアーの予約) エージェントの [Agent Interaction Duration (エージェントのインタラクション時間)] がしきい値を超えました」というアラート通知を受け取りました。
そこで、シンプルな調査手順に従います。
ステップ 1: 通知を開く
[Observe & Optimize (観察および最適化)] | [Alerts (アラート)] で、Alex はメールまたはアプリケーション内通知で届いた通知リストを開きます。[Metric (メトリクス)] を [Agent Interaction Duration (エージェントのインタラクション時間)] で絞り込みます。
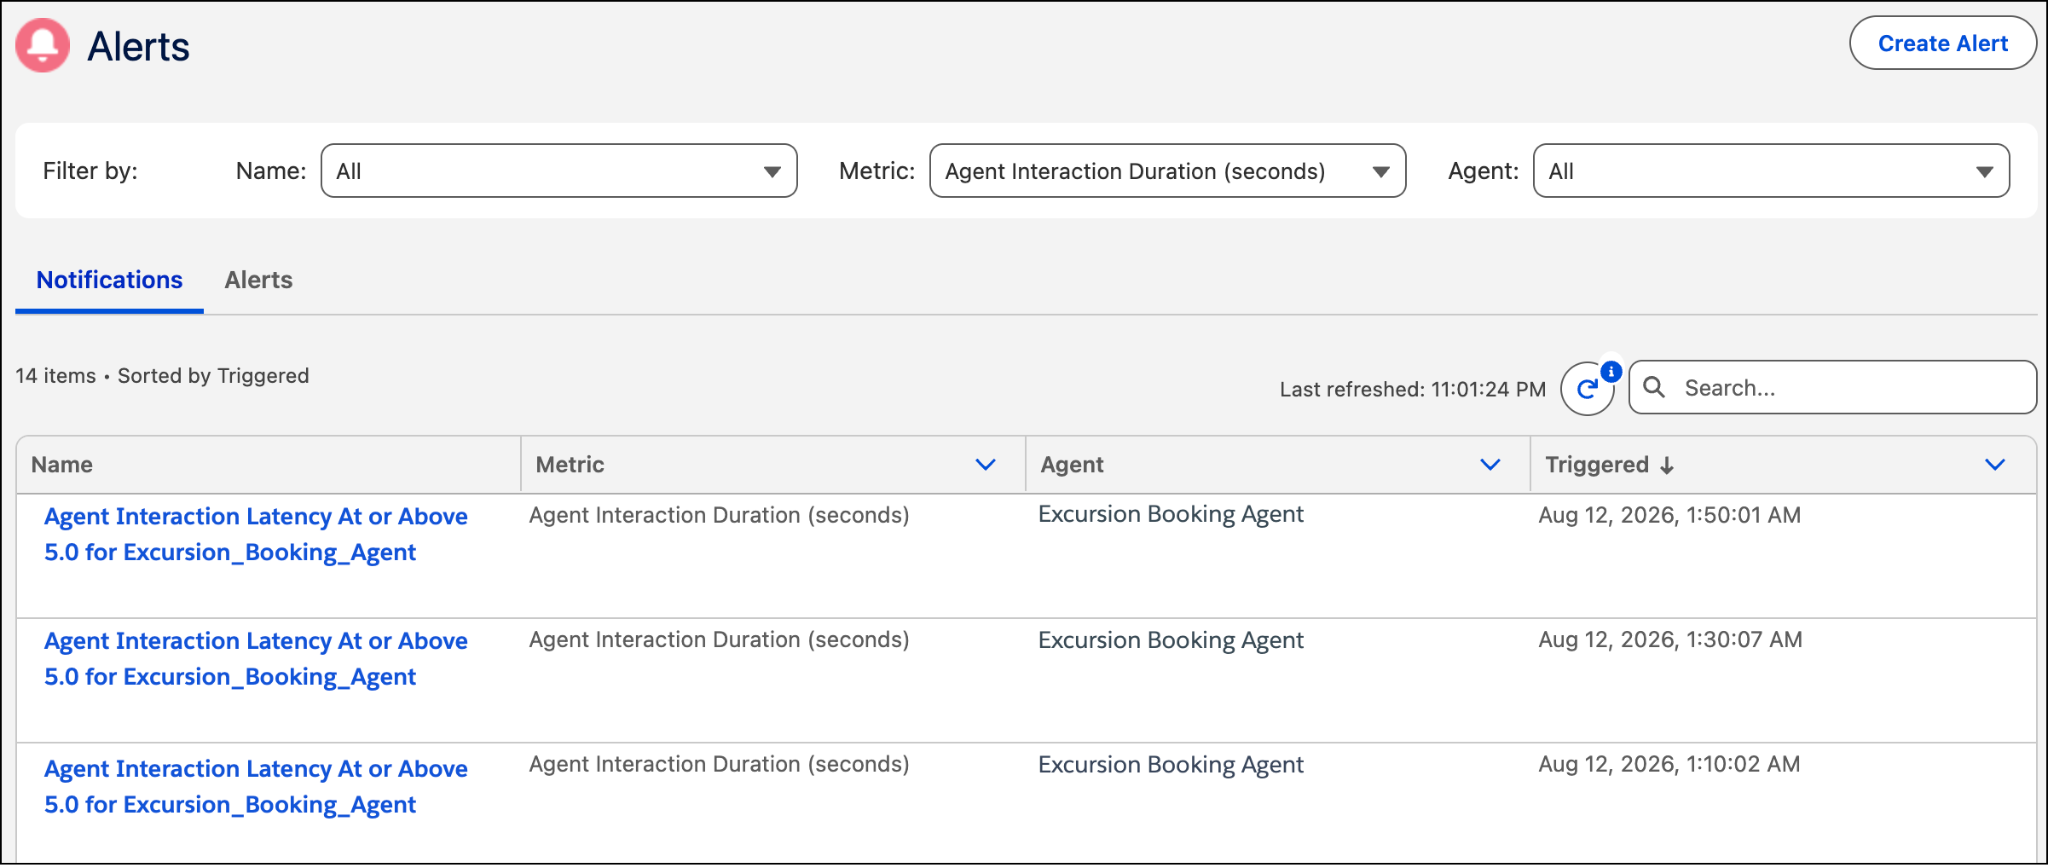
各通知に重要なコンテキストが記載されています。
- アラート名
- 該当するメトリクスまたはスコア
- エージェント
- トリガーのタイムスタンプ
次に、トリガーされたアラートの中から調査するものを選択します。するとすぐ、アラート条件に関連するインタラクションに絞り込まれます。
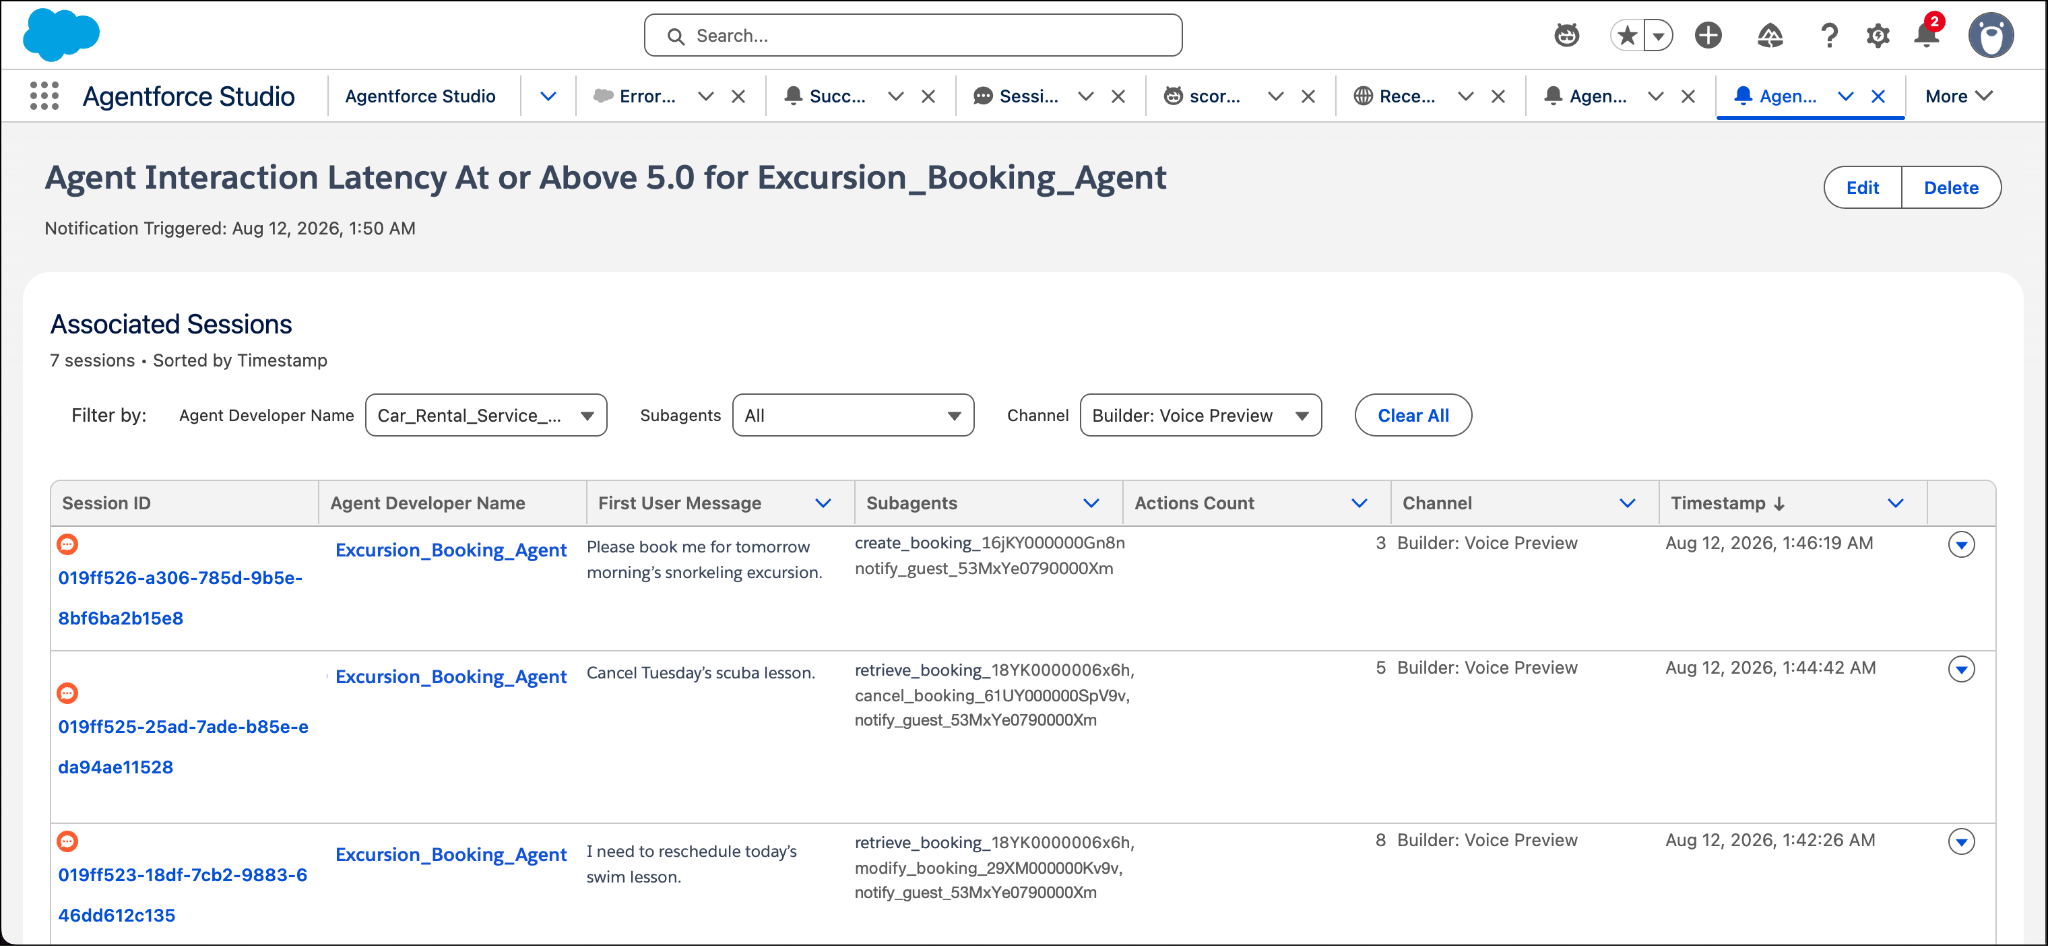
ステップ 2: 関連するセッションを詳しく調べる
Alex はセッションの行全体に目を通し、次のようなパターンが見られないか確認します。
- サブエージェントが繰り返し関与している。
- ユーザーインテントが似ている。
- セッションの結果に共通点がある (例: 放棄、エスカレーション)。
- 時間的なクラスタリングから、インシデントが発生した時間帯が示唆される。
ステップ 3: 個々の会話を開く
Alex は複数のセッション ID を開いて、会話フローを確認します。
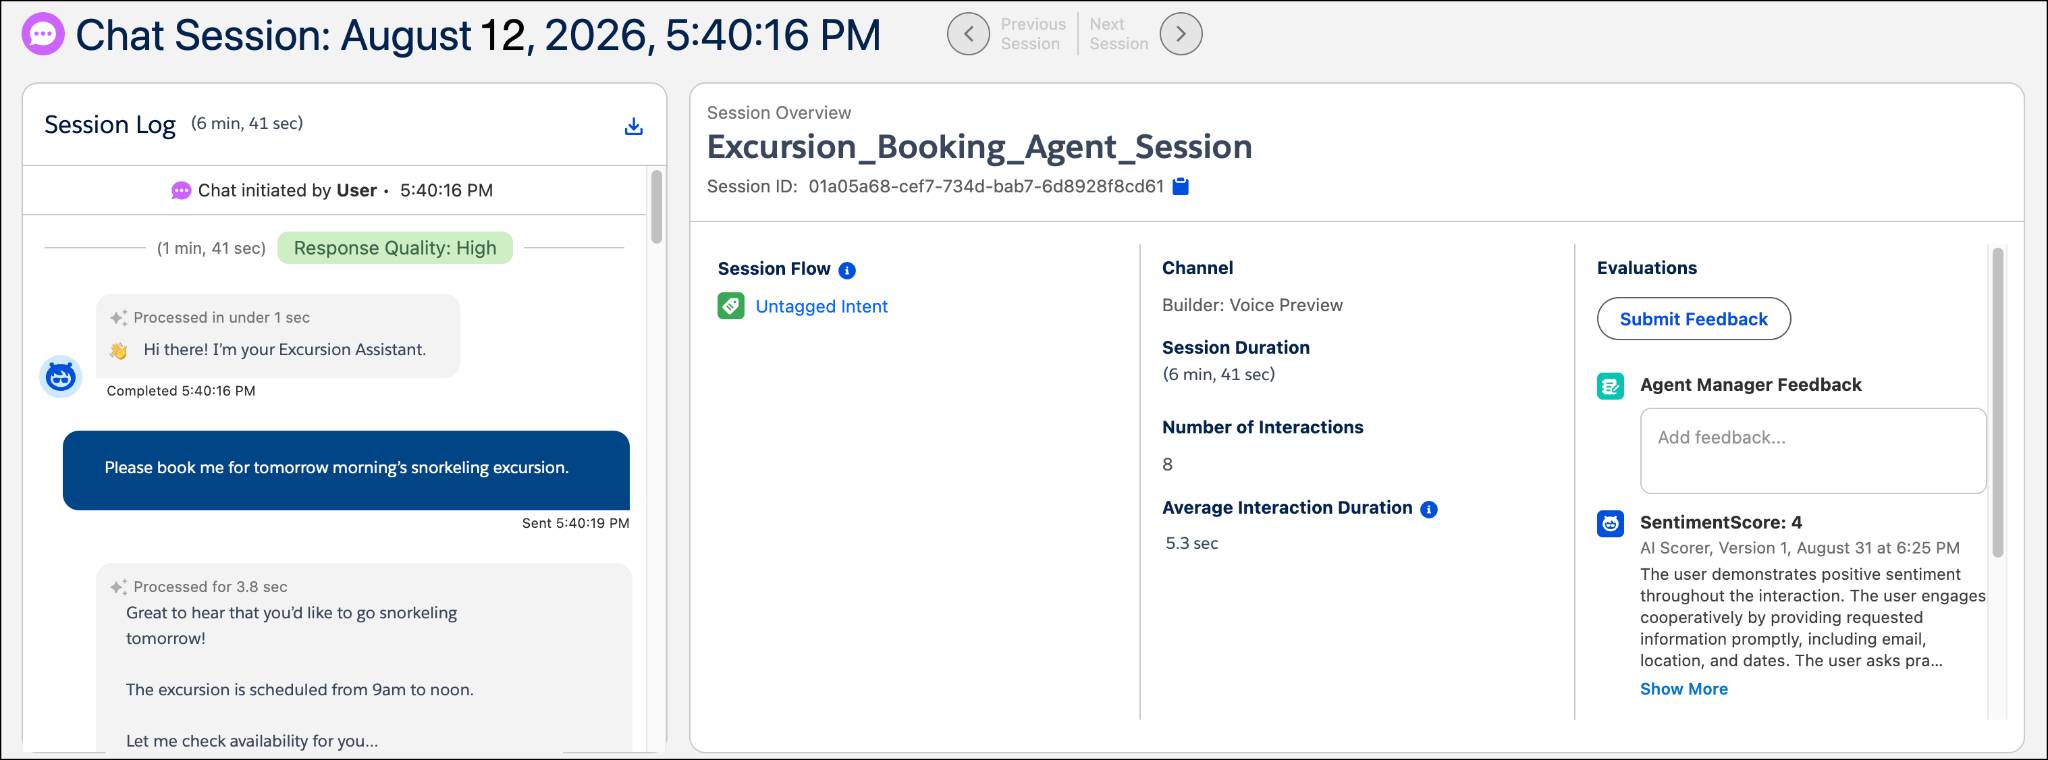
各セッションページで、次の点を確認します。
- ゲストと AI エージェント間のターンごとのやり取り
- エージェントが応答に要した時間
- 処理が遅延または失敗した箇所のトレースの詳細
- サブエージェントのルーティングとエージェントアクションの実行パターン
こうした情報から、Alex は症状と原因を区別することができます。
アラートを基にアクションを実行する
遅延に関するアラートは、特に週末の急増時に、Water Activities Booking (水活動の予約) サブエージェントが関与するセッションに集中しています。
会話とトレースを確認した結果、Alex は再現性のあるパターンを見出しました。
- ゲストが 1 回のリクエストで空き状況と料金を問い合わせる。
- サブエージェントが複数のエージェントアクションを順番に呼び出す。
- 1 回の取得ステップでタイムアウトになることが多く、応答全体に時間がかかっている。
- 遅延が原因で、予約が完了する前にドロップオフが発生する。
十分な根拠を集めた Alex は、修正の優先順位を決めることにします。
- 空き状況と料金を同時に問い合わせるリクエストに対するサブエージェントの決定パスを簡素化する。
- 指示を更新して、複数のアクションをトリガーする前に、サブエージェントが確認の質問を 1 つ行うようにする。
- 取得の遅延が内部制限を超えた場合のフォールバック動作を追加する。
- 更新後の動作を Agentforce テストセンターで再度テストしたうえで実装し、継続的に監視する。
実装後も、Alex は同じ遅延と放棄のアラートに注意します。その後数週間のうちに通知が減少し、応答時間が安定し、週末の予約完了率が改善しました。
これこそがプロアクティブなオブザーバビリティの実践です。早い段階で検知し、速やかに調査し、継続的に改善していきます。
健全性監視のベストプラクティス
- 価値の高い少数のアラートセットから始め、徐々に拡大していく。
- 推測ではなく、過去のデータとビジネスのしきい値を使用する。
- アラートシグナルの品質を頻繁に見直し、しきい値を調整してノイズとなる通知を減らす。
- 各アラートに必ず明確な所有者と応答プレイブックを定めておく。
- プロンプトテンプレート、サブエージェント、エージェントアクションを変更する前に、セッションと会話を調査する。
- 修正後にメトリクスを追跡して、変更によって結果が改善されたことを検証する。
まとめ
自動アラート、しきい値に基づく検出、的を絞った調査ワークフローを使用して、AI エージェントの健全性を積極的に監視する方法を学習しました。Alex Wu が通知に基づいて問題のあるセッションを特定し、会話レベルの動作を詳しく調べ、お客様への影響を軽減する改善策を重点的に実施するところを見てきました。
エージェント健全性監視を使用すれば、AI エージェントの管理をリアクティブなデバッグから、データドリブンの継続的な信頼性管理に移行できます。
リソース
- Salesforce ヘルプ: Monitor Agent Health (エージェントの健全性監視)
- Salesforce ヘルプ: Agent Analytics (エージェント分析)
- Salesforce ヘルプ: Customize Agentforce Observability (Agentforce Observability のカスタマイズ)
- Salesforce ヘルプ: Agentforce Session Tracing (Agentforce セッション追跡)
- Salesforce ヘルプ: Analyze Data with Agent Optimization (エージェント最適化を使用したデータの分析)