AI のデータバイアスを特定して評価する
学習の目的
この単元を完了すると、次のことができるようになります。
- データバイアスとは何か、人工知能システムでなぜ重要なのかを説明する。
- AI アプリケーションのデータバイアスを認識し、評価する。
- データセット内のデータバイアスのよくある原因を認識する。

データバイアスとは
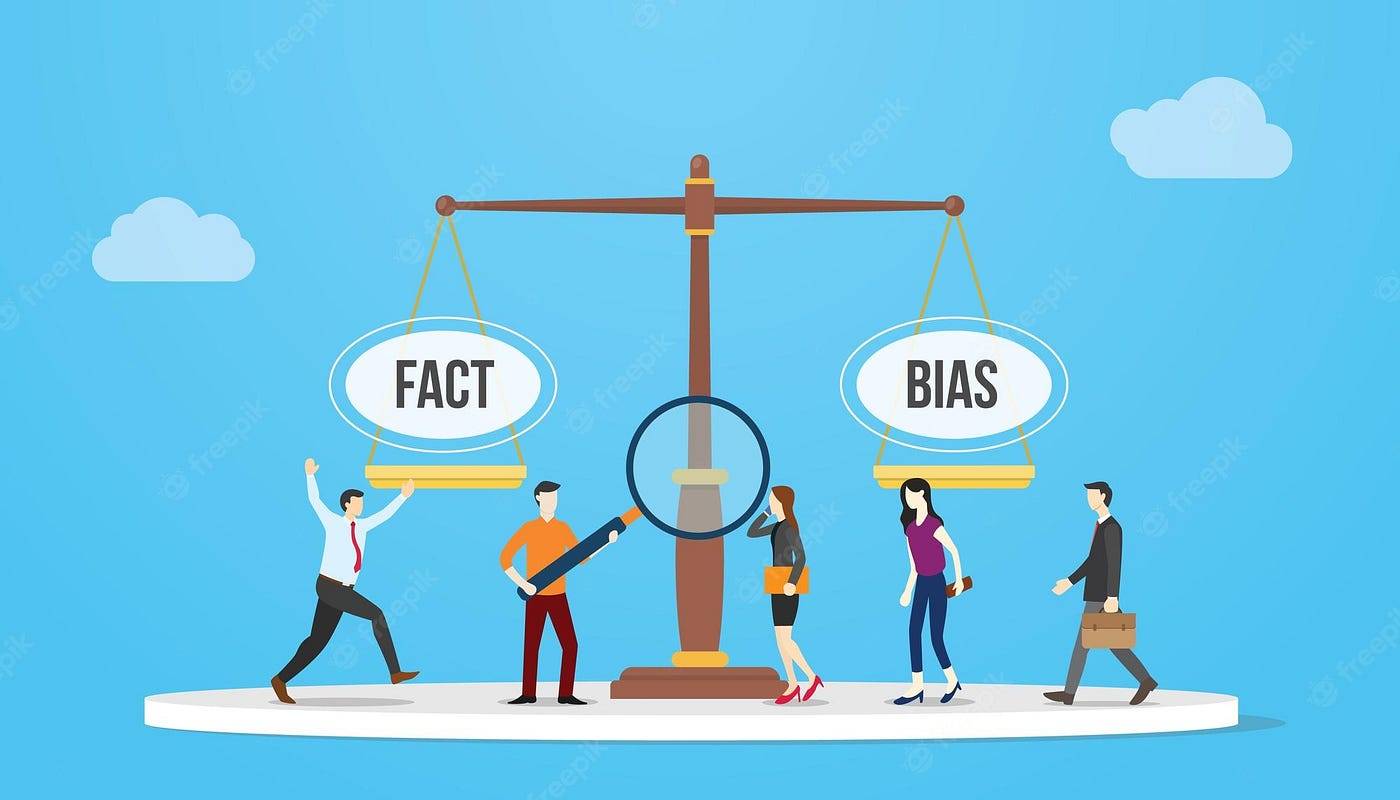
データバイアスは、私たちが日常的に利用している人工知能システムで重要な役割を果たしています。これにより、人間のバイアスを反映した偏った出力や、有害な結果につながる可能性があります。データバイアスは、手元にある情報が本来あるべき姿を正確に反映していない場合に生じます。重要な詳細を伏せたり、不正確または不完全な事実を伝えたりする動画を見ていると想像してみてください。そのような情報によって、完全には正しくないことを信じてしまう可能性があります。だからこそ、データバイアスを認識して評価することが、AI で公平かつ正確な結果を確保するうえで不可欠なのです。
データバイアスがあると、対象となる母集団がデータに正しく反映されないため、系統的な偏差が生じ、不正確または不公平な結果につながる可能性があります。AI システムでは、データバイアスがモデルのパフォーマンスと意思決定能力に直接影響を与えます。このように影響範囲が広いため、偏ったデータは不公平な結果や誤った推奨につながり、広範囲にわたる影響をもたらす可能性があります。
データバイアスの種類
このセクションでは、データバイアスの主な 2 つの種類であるサンプリングバイアスと確証バイアスを探り、それらが人間のバイアスとどのように関連しているかを考察します。これらの種類のバイアスを理解すると、人間のバイアスがデータの収集と分析にどのように意図せず影響を与え、不公平な AI システムにつながりうるのかを把握できます。
サンプリングバイアス
サンプリングバイアスは、データ収集プロセスで特定のグループに偏って選んだり、ほかのグループを除外したりすることで、データが真にランダムでなくなったり、母集団全体を代表しなくなったりする場合に発生します。サンプリングバイアスは、AI モデルの結果に不正確さをもたらす可能性があります。データサイエンティストは、AI モデルのサンプルデータを選択するときに、常に母集団全体を考慮する必要があります。
例として、セキュリティ目的で顔を認識するようにトレーニングされた顔認識システムを取り上げます。サンプリングバイアスが原因で、AI 顔認識システムは、トレーニングデータに多く含まれていた特定のデモグラフィックグループ以外の個人に対しては、正確に機能しない場合があります。高齢者や、人種的背景の異なる個人の顔をうまく認識できないことがあります。つまり、特定のグループでは誤認識が起きやすく、偽陽性や偽陰性の発生率も高くなる傾向があります。
偽陽性は、システムが一致していない人を誤って一致していると識別した場合に発生します。これにより、無実の個人が潜在的な容疑者として誤ってフラグを立てられる可能性があります。偽陽性の結果は深刻なものになる可能性があり、無実の人が法的影響を受けることがあります。プライバシーの喪失、個人や職業上の評判への損害、個人の権利の侵害につながる可能性があります。一方、偽陰性は、システムが有効な一致を認識できない場合に発生します。これは、本来識別されるべき個人がシステムによって検出されない可能性があることを意味します。偽陰性は、犯罪解決の機会を逃す結果につながり、公共の安全を損なう可能性があります。
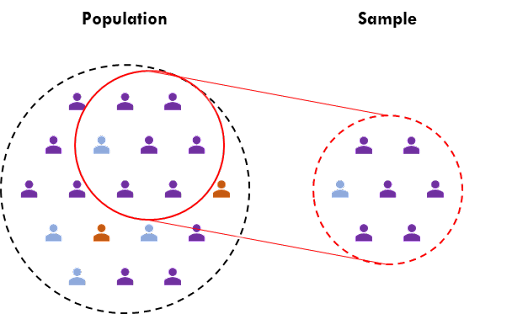
サンプリングバイアスの別の例を見てみましょう。ある都市で何人の人がアイスクリームを好きかを知りたいとします。調べるために、近所のアイスクリームショップで人々にアンケートを実施します。ただし、お店の中にいる人にしか聞かず、通りがかりの人やお店を訪れない人には聞きません。アイスクリームがすでに好きな特定のグループの意見しか集められていないため、これはサンプリングバイアスを生み出します。お店を訪れない人や異なる好みを持つ人の意見を見落としています。これにより、市全体がアイスクリームをどれだけ好きかについて、不正確な結論が導かれる可能性があります。
確証バイアス
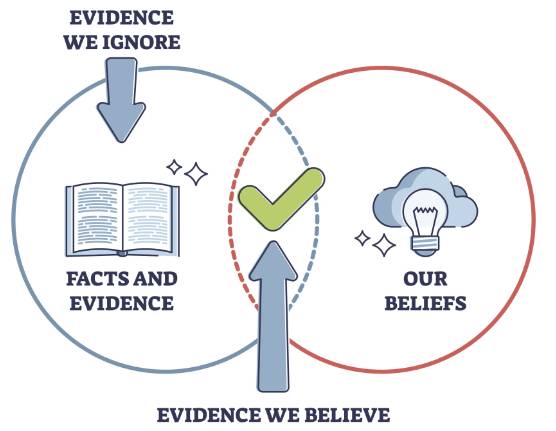
確証バイアスとは、自分の既存の信念に一致する情報を探し、矛盾する証拠を無視したり見過ごしたりすることで情報を処理しようとする傾向のことです。別の視点を考慮せず、自分がすでに信じていることを支持する情報を優先することです。これは意思決定に影響を与え、別の視点の見落としにつながる可能性があります。
ローンの承認対象者を決定するためにトレーニングされた AI モデルを想像してください。AI のトレーニングに使用されたデータが特定のグループへのローン承認を多く含む場合、AI はそれらの特定のグループを優遇するようになる可能性があります。これにより、AI が過去に承認された人と類似した人のローンをより多く承認する一方で、ほかのグループの適格な申込者を見落とすという、偏った決定につながる可能性があります。トレーニングデータに含まれるこの確証バイアスは、特定の個人を排除することで不公平な結果につながる可能性があります。
潜在的バイアス
潜在的バイアスとは、将来発生する可能性のあるバイアスを指します。エラーや事故は意図して起こるものではありませんが、それでも発生してしまいます。バイアスが意図せず混入することで、人工知能や機械学習のアプリケーションの開発に使用されるデータの品質に影響を及ぼす可能性があります。
データバイアスの一般的な原因
バイアスはさまざまな形でデータの収集、活用、分析に入り込み、影響を与える可能性があります。注意すべきバイアスをいくつか次に示します。
人間のバイアス
データの収集と分析のプロセスは、人間のバイアスの影響を受けることがあります。これにより、データの収集方法、質問の内容、または解釈の仕方が意図せず左右され、偏った結果につながる可能性があります。
データの収集方法
バイアスは、データの収集に使用する方法を通じて生じることがあります。たとえば、アンケートの質問は、特定の回答を引き出したり、特定のグループを対象としたりするような形で表現されることがあります。また、回答者の選定基準からバイアスが生じ、代表性のないサンプルにつながることもあります。
不完全なデータまたは欠損データ
特定のグループが除外されるといった、不完全なデータや欠損データからバイアスが生じることがあります。これにより分析が歪められ、調査結果の妥当性が損なわれる可能性があります。
構造的バイアス
データバイアスは、データ生成プロセスに潜む根本的な構造的バイアスに起因することがあります。歴史的な不平等、不均等な権力関係、または差別的な慣行が、偏ったデータの原因となることがあります。
データバイアスを特定して評価する手法
データバイアスの発生源がわかったところで、データバイアスを特定して評価するための効果的な手法をいくつか見ていきましょう。
|
ツール
|
使用方法
|
|---|---|
|
統計分析
|
平均、中央値、標準偏差などの記述統計を使用することで、データの潜在的な不一致や外れ値を明らかにできます。 |
|
データ視覚化
|
グラフ、チャート、ヒストグラムなどを使ってデータを視覚化することで、データバイアスに関する有益なインサイトを得ることができます。箱ひげ図や散布図などの視覚化の手法を使うと、バイアスを示すパターンや異常を特定しやすくなります。 |
|
データ探索
|
徹底的なデータチェックや検証を通じてデータを探索することで、バイアスの潜在的な原因を特定できます。 |
|
外部検証
|
データセットを外部または独立した情報源と比較することで、バイアスを評価するための追加的な手段を得ることができます。 |
|
ピアレビューとコラボレーション
|
同僚、エキスパート、またはピアから意見やフィードバックを求めることで、データバイアスの評価を向上させることができます。コラボレーションによる取り組みは、個人では見落とされがちなバイアスの特定に役立ち、多様な視点をもたらします。 |
リソース